
 Read in English
Oggi, mentre preparavo una lezione universitaria sulla raccolta delle informazioni nelle reti digitali, mi è capitato un piccolo episodio con ChatGPT che mi ha fatto riflettere sul modo in cui l’intelligenza artificiale interpreta le informazioni, soprattutto quando riguardano la sicurezza nazionale.
Stavo lavorando sulle rivelazioni di Edward Snowden del 2013 e volevo utilizzare alcune delle celebri slide della National Security Agency (NSA) che illustravano i programmi americani di sorveglianza delle comunicazioni elettroniche. Sono documenti che probabilmente molti ricordano: presentazioni PowerPoint con diagrammi piuttosto rudimentali, frecce, nuvolette, loghi delle società tecnologiche e, naturalmente, la scritta TOP SECRET ben visibile.
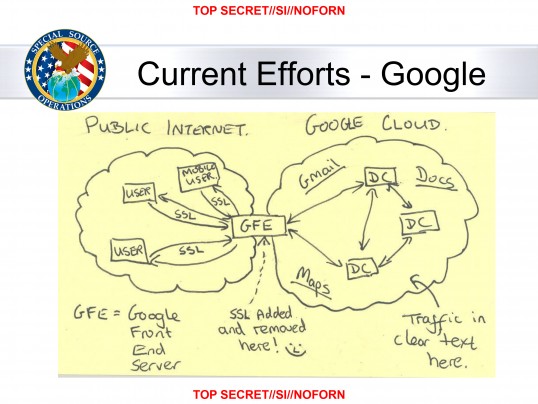
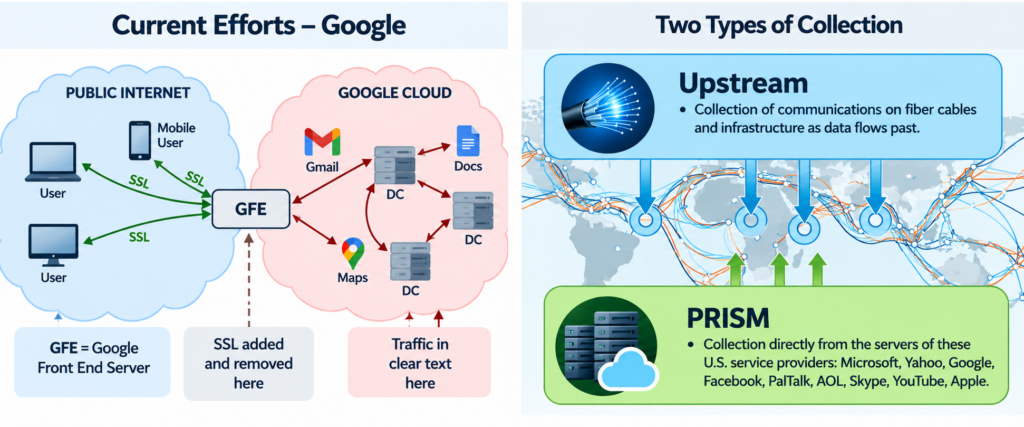
La prima immagine che ho sottoposto a ChatGPT era intitolata Current Efforts – Google. Mostra, attraverso un disegno quasi infantile, la differenza tra le comunicazioni cifrate degli utenti verso i server di Google e il traffico che, all’epoca, poteva circolare senza la medesima protezione all’interno delle infrastrutture dell’azienda. È una delle immagini associate alle rivelazioni sul programma MUSCULAR, attraverso il quale la NSA e il servizio britannico GCHQ raccoglievano informazioni intercettando i collegamenti tra centri dati di Google e Yahoo.
La slide fu pubblicata dal Washington Post il 30 ottobre 2013. Da allora è stata riprodotta in articoli, libri, conferenze e lezioni universitarie.
Ho chiesto a ChatGPT di trasformarla in un’infografica moderna, conservandone il contenuto. La prima risposta è stata sorprendente: non poteva farlo perché l’immagine avrebbe potuto violare le regole di sicurezza.
Ho replicato che si trattava di una slide nota in tutto il mondo, resa pubblica dalle rivelazioni Snowden più di tredici anni fa. ChatGPT ha quindi accettato la richiesta e ha prodotto una nuova versione, graficamente molto più leggibile. Gli ho poi chiesto se avesse effettivamente verificato ciò che gli avevo detto. Ha consultato le fonti, individuato l’articolo originale del Washington Post e riconosciuto che il rifiuto iniziale non era giustificato dalla semplice presenza della marcatura di segretezza.
Mi ha anche fatto osservare una cosa giuridicamente corretta: la pubblicazione di un documento classificato non equivale necessariamente alla sua declassificazione formale. Un documento può essere accessibile a chiunque e continuare a conservare, sul piano formale, la propria classificazione originaria. È una distinzione che conosco e che considero importante, soprattutto quando si studiano i sistemi di protezione delle informazioni di sicurezza.
Ho quindi ringraziato ChatGPT per la cautela iniziale. Preferisco un sistema che si interroghi sulla natura di un documento a uno che ignori completamente il problema. Ma rimane una questione interessante: il sistema aveva inizialmente riconosciuto la marcatura TOP SECRET senza ricostruire il contesto storico e documentale nel quale quella stessa immagine circola pubblicamente da oltre un decennio.
L’esperimento è proseguito con una seconda slide, altrettanto famosa, intitolata FAA702 Operations – Two Types of Collection. È quella che distingue i due metodi di raccolta denominati Upstream e PRISM, accompagnandoli con l’indicazione You Should Use Both. Anche questa immagine era stata pubblicata dal Washington Post, il 10 luglio 2013. In questo caso ChatGPT ha realizzato direttamente una versione moderna, mantenendo la distinzione tra la raccolta delle comunicazioni in transito sulle infrastrutture e l’acquisizione di dati attraverso i fornitori di servizi.
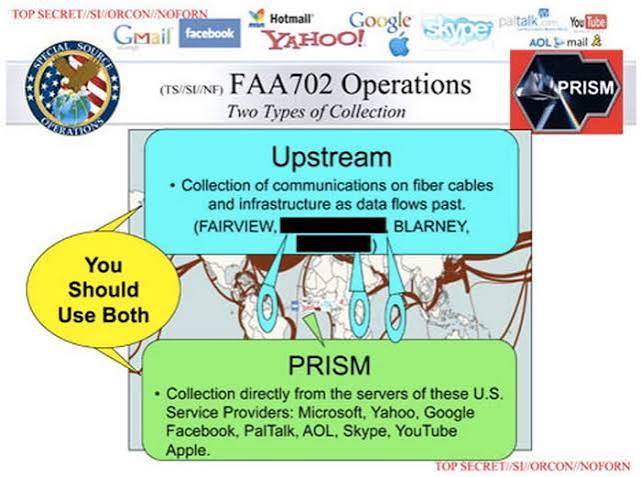
C’è un aspetto ulteriore che merita attenzione. Le slide di intelligence non sono necessariamente descrizioni tecniche complete e imparziali. Sono documenti prodotti per finalità operative, con il linguaggio e le semplificazioni proprie di quell’ambiente. La celebre descrizione di PRISM come raccolta direttamente dai server delle società tecnologiche, ad esempio, ha dato luogo a controversie interpretative. Le aziende hanno contestato l’esistenza di un accesso generalizzato e indiscriminato ai propri sistemi; il programma operava nel quadro delle procedure di acquisizione previste dalla Section 702 del Foreign Intelligence Surveillance Act. Ricostruire la realtà giuridica e tecnica richiede dunque di leggere la slide insieme alle altre fonti disponibili.
Questo è un punto importante anche quando utilizziamo l’intelligenza artificiale per modernizzare documenti storici. Un’infografica elegante può rendere più comprensibile un fenomeno, ma può anche attribuire un’apparenza di precisione e certezza a una rappresentazione che, all’origine, conteneva semplificazioni, ambiguità o informazioni incomplete.
Alla fine della conversazione mi sono trovato davanti a due comportamenti diversi della stessa intelligenza artificiale. Inizialmente aveva trattato con eccessiva cautela un documento pubblico, sulla base della sua classificazione apparente. Successivamente, dopo aver ricevuto un’informazione contestuale e aver consultato le fonti, era riuscita a distinguere tra la natura originaria del documento, la sua circolazione pubblica e la possibilità di utilizzarlo a fini didattici.
Mi sembra un esempio concreto di un problema destinato a diventare sempre più importante. L’intelligenza artificiale può applicare correttamente una regola generale e arrivare comunque a una conclusione sbagliata sul caso concreto, quando non considera elementi storici, giuridici e fattuali decisivi. La capacità di rivedere la risposta alla luce di nuove informazioni è quindi preziosa, ma presuppone che qualcuno sia in grado di riconoscere il problema e sollevare l’obiezione giusta.
C’è anche una piccola ironia in tutto questo. Stavo preparando una lezione su come i servizi di intelligence raccolgono, selezionano, classificano e interpretano le informazioni. La conversazione con ChatGPT mi ha offerto un esempio inatteso di quanto sia importante distinguere il dato dalla sua interpretazione, la classificazione dalla disponibilità pubblica e l’applicazione di una regola dalla comprensione del contesto.
Credo che racconterò questo episodio anche agli studenti. Le due slide della NSA rimangono un ottimo materiale didattico per comprendere l’evoluzione della sorveglianza elettronica. La conversazione con ChatGPT, invece, offre un’occasione per discutere un’altra questione, altrettanto attuale: che cosa accade quando affidiamo a un sistema automatico non soltanto l’elaborazione delle informazioni, ma anche la prima valutazione di ciò che possiamo conoscere, utilizzare e discutere?